오픈AI 데이터셋에 저작물 복제본 9만여 건…소송 서면 비공개 해제
뉴욕타임스가 3년 전 오픈AI와 마이크로소프트를 상대로 낸 저작권 소송에서 비공개 처리가 해제된 정보가 공개됐다. 뉴욕타임스 측 서면에 인용된 두 회사의 내부 발언과 자료가 담겨, AI 학습이 원저작물 시장을 대체하는지를 다투는 쟁점과 맞물린다.
뉴욕타임스는 두 회사가 자사 콘텐츠로 생성형 AI 모델을 학습해 저작권법을 위반했다고 주장해 왔다. 뉴욕타임스 측 서면은 두 회사가 유료 장벽을 우회해 콘텐츠를 확보하고, 웹 콘텐츠를 대량으로 자동 수집하는 방식인 스크래핑으로 학습 데이터셋을 만들었으며, 학습 데이터에서 저작권 표시를 의도적으로 제거했다고 주장한다.
공개된 문서에는 오픈AI의 한 데이터셋에 저작물 복제본이 9만1692건 넘게 포함됐다는 내용이 있다. 다만 입력된 자료가 해당 문장 중간에서 끊겨 복제 대상이 어떤 범위의 저작물인지는 확인되지 않는다. 새 정보의 상당 부분은 비공개 상태인 증거물 자체가 아니라 뉴욕타임스 측 서면에서 나왔고, 인용문도 원래 맥락 없이 제시됐다. 입력 자료에는 두 회사의 반박이 제시되지 않았다.
서면에 인용된 클릭률 자료
소송 서면에 인용된 마이크로소프트 자체 데이터에서는 코파일럿 답변 엔진을 이용할 때 뉴욕타임스 도메인의 클릭률이 기존 빙 검색보다 최대 93% 감소한 것으로 나타났다. 서면에 인용된 2024년 1월 마이크로소프트 내부 발표자료는 이런 감소가 모델 성능과 웹 전체를 함께 해칠 수 있다고 평가했다. 같은 자료는 최종 제품이 핵심 콘텐츠 공급자의 경제적 기반을 위협하는 상황이라고 기술했다.
서면에 인용된 내부 평가와 증언
서면에 인용된 내부 커뮤니케이션에서 오픈AI의 닉 털리는 챗봇 같은 제품이 발행인에게 실존적 위협이며 상당 부분 대체재라고 평가했다. 그는 성능이 좋아질수록 대체성이 커질 것이라고 봤다. 서면에 따르면 오픈AI의 그레그 브록먼은 자사 모델이 뉴스에 매우 뛰어나다고 표현했다. 서면에 인용된 마이크로소프트 문서는 생성형 AI가 AI 모델의 학습 데이터를 만든 사람들의 고용을 크게 훼손할 실질적 위험이 있다고 평가했다.
소송 자료에 따르면 사티아 나델라 마이크로소프트 최고경영자는 2026년 증언에서 유료 콘텐츠를 학습이나 근거 제공에 이용하려면 라이선스가 필요하다고 말했다. 그는 오픈AI가 유료 장벽 뒤 정보를 수집해 학습한 사실을 알았다면 모델 재학습을 요구할 권리를 행사했을 것이라고도 밝혔다. 같은 증언에서 그는 챗봇이 정보를 직접 제공하면서 이용자가 원 출처를 방문할 필요를 대체했다는 취지에 동의했다.
아직 정리되지 않은 법적 쟁점
공정이용은 패러디·뉴스 보도·비평 등 일정한 경우 저작권자 허락 없이 저작물을 이용할 수 있게 하는 법리다. 원저작물 시장을 대체하거나 침해하는지 여부가 판단 요소 가운데 하나로 제시된다. 저작권 자료를 AI 학습에 이용할 수 있는지에 관한 법적 결론은 아직 명확하지 않으며, 판사들은 학습이 공정이용이라는 AI 기업 측 주장에 대체로 우호적이었던 것으로 전해진다. 2026년 9월 트럼프 행정부는 오픈AI의 비인가 저작물 학습 이용을 옹호하는 의견서를 제출했다.
사진
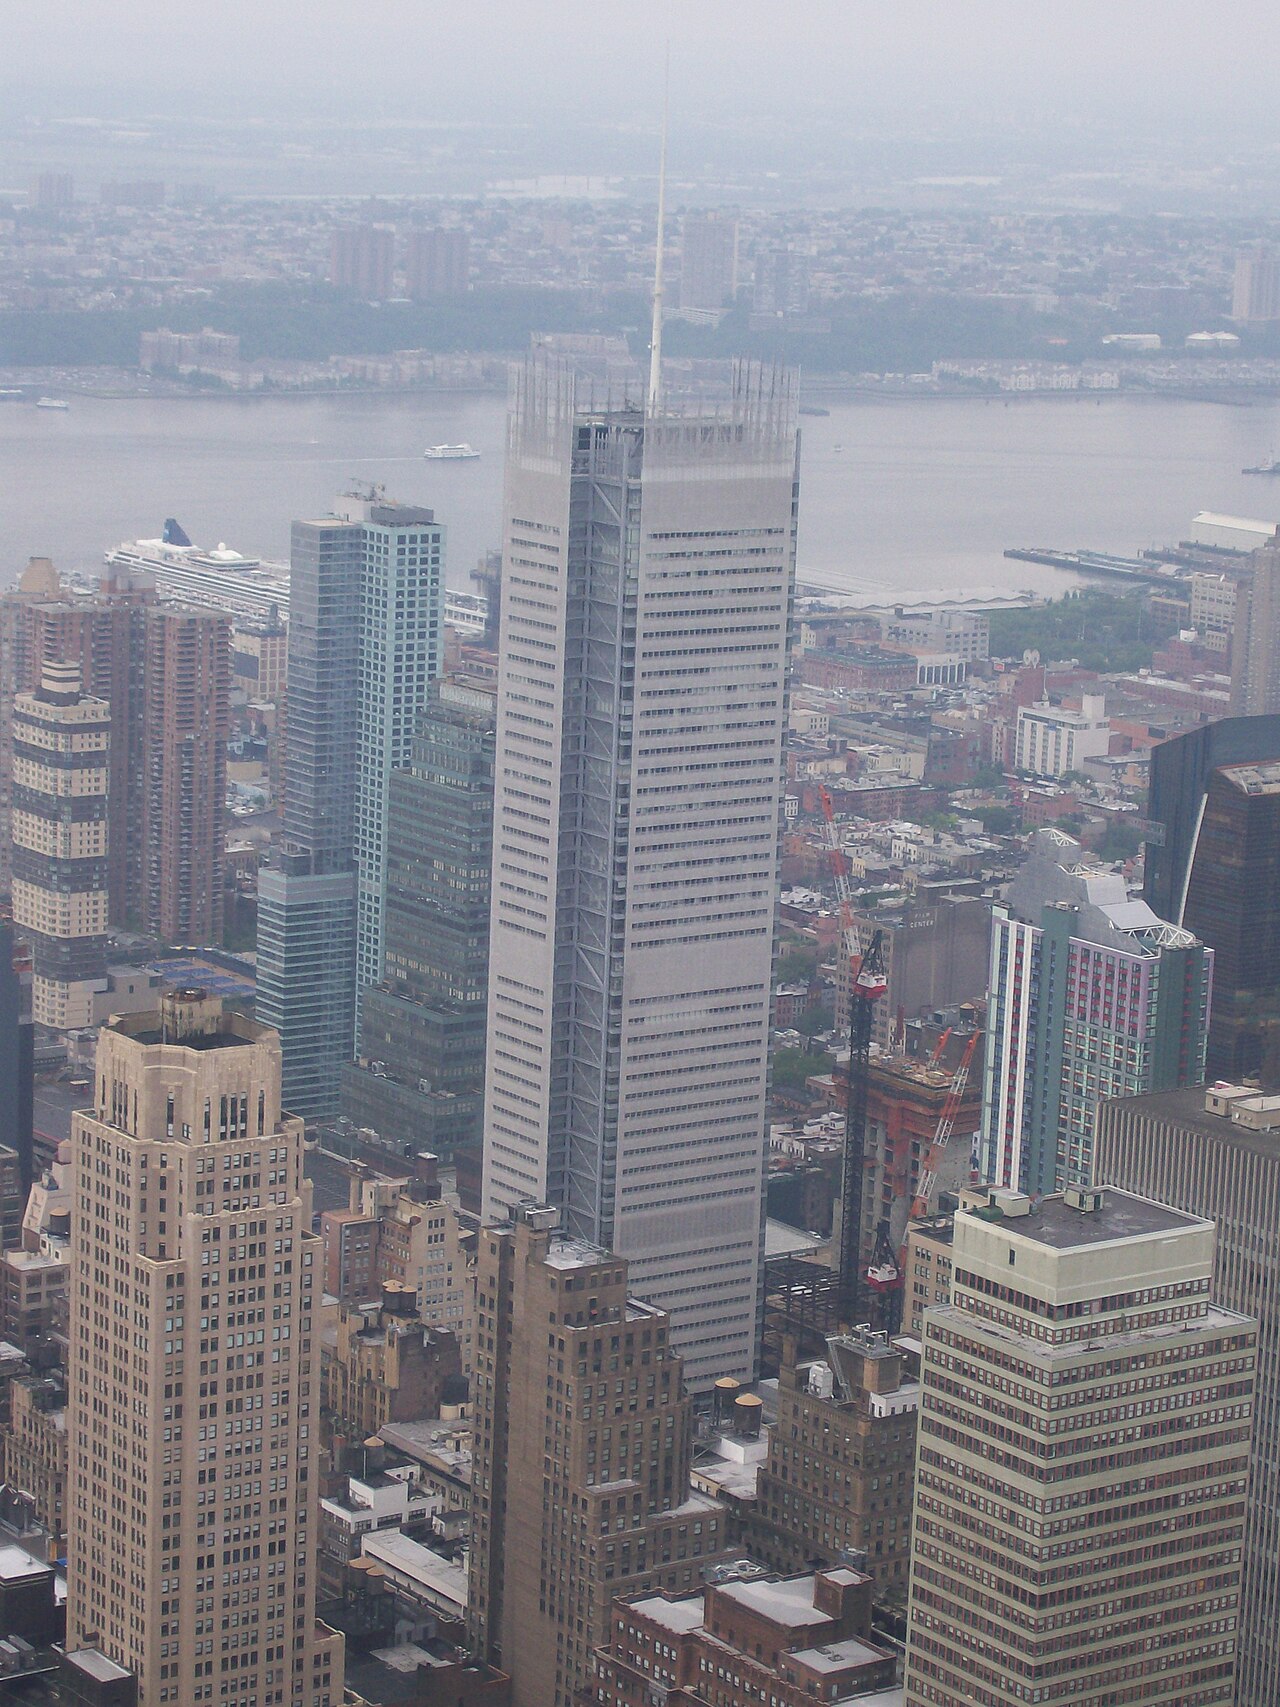
총 2건- 뉴욕 맨해튼의 뉴욕타임스 사옥 · 자료사진
- 마이크로소프트 레드먼드 캠퍼스 17동 정문 · 자료사진